NPS com rigor estatístico: como separar ruído de mudança real e descobrir o que move o indicador
Por André Luiz Maciel · Coordenador de Qualidade, especialista em CX e análise de dados · Código aberto em GitHub
dados_sinteticos.py. O objetivo é mostrar o método; nenhum dado de empresa real é usado.Toda central de atendimento conhece a cena: o NPS do mês cai três pontos e a reunião vira uma caça ao culpado. No mês seguinte sobe quatro e ninguém sabe dizer por quê. O problema raramente é o atendimento; é a leitura do indicador. Esta publicação reúne, de forma aplicada, o roteiro estatístico que uso para responder três perguntas antes de qualquer plano de ação:
- A variação é real ou é ruído de amostra?
- Ela veio de mudança no tipo de caso ou de piora no mesmo tipo de caso?
- Quais fatores tiram mais pontos e quanto valeria corrigir cada um?
É a aplicação prática de uma ideia que defendo: “Qualidade não é controle. É alavanca estratégica de resultado.” A Qualidade só vira alavanca quando lê os números com método.
1. O NPS é uma média e isso muda tudo
Dê a cada resposta o valor +100 (promotor, notas 9–10), 0 (neutro, 7–8) ou −100 (detrator, 0–6). A média desse vetor é exatamente o NPS. Como é uma média, ela tem variância e, portanto, margem de erro:
\(\mathrm{NPS} = 100\,(p_+ - p_-) \qquad \mathrm{var} = p_+ + p_- - (p_+ - p_-)^2 \qquad \text{margem}_{95\%} = 1{,}96\,\sqrt{\mathrm{var}/n}\times 100\)
Na base fictícia, o NPS do período é 42.2 com margem de ±2.5 pontos. Em um único mês, com 200 a 400 respostas, a margem passa facilmente de ±8 pontos. Ou seja: boa parte do “sobe e desce” cabe dentro do ruído.
2. Ruído ou mudança real? Teste mês contra mês e carta de controle
Para comparar dois meses, use o teste z da diferença de duas médias independentes:
\(z = \dfrac{\mathrm{NPS}_2-\mathrm{NPS}_1}{100\sqrt{\mathrm{var}_1/n_1+\mathrm{var}_2/n_2}}\)
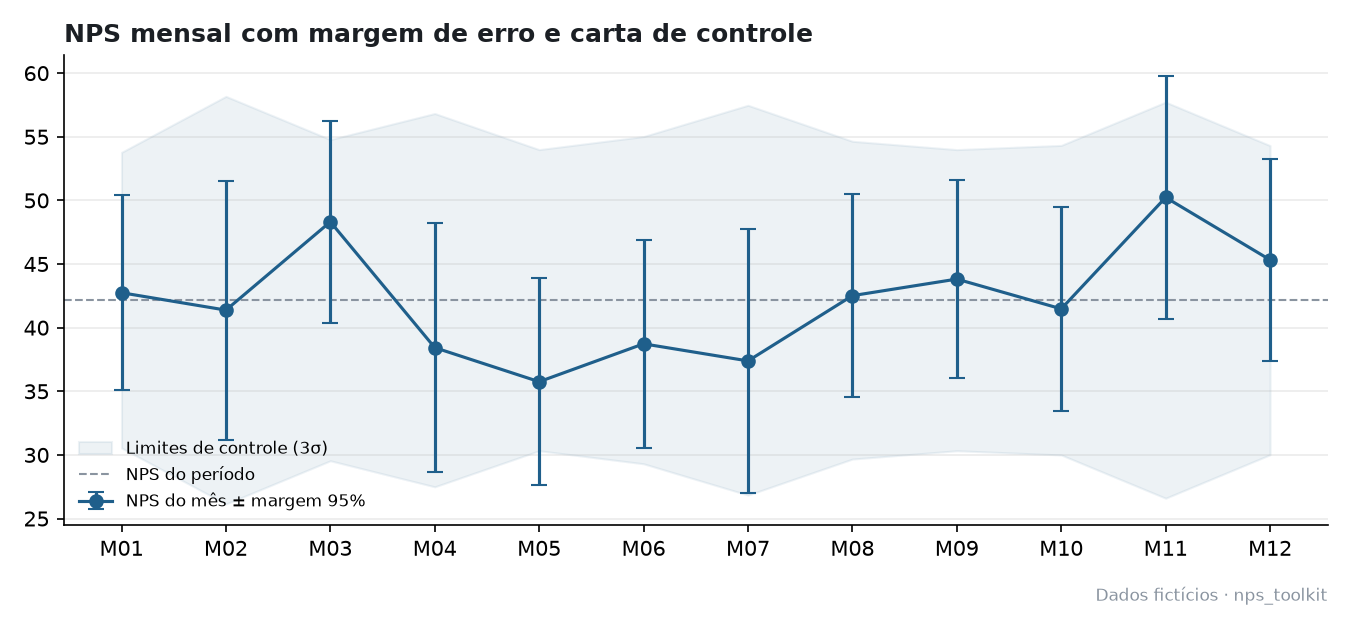
| Mês | Respostas | NPS | Margem 95% (±) | Δ vs mês anterior | p-valor |
|---|---|---|---|---|---|
| M01 | 386 | 42.7 | 7.7 | – | – |
| M02 | 203 | 41.4 | 10.2 | -1.4 | 0.83 |
| M03 | 327 | 48.3 | 7.9 | +6.9 | 0.29 |
| M04 | 242 | 38.4 | 9.8 | -9.9 | 0.12 |
| M05 | 372 | 35.8 | 8.1 | -2.7 | 0.68 |
| M06 | 315 | 38.7 | 8.2 | +3.0 | 0.61 |
| M07 | 222 | 37.4 | 10.4 | -1.3 | 0.84 |
| M08 | 334 | 42.5 | 8.0 | +5.1 | 0.44 |
| M09 | 372 | 43.8 | 7.8 | +1.3 | 0.82 |
| M10 | 352 | 41.5 | 8.0 | -2.3 | 0.68 |
| M11 | 215 | 50.2 | 9.6 | +8.8 | 0.17 |
| M12 | 353 | 45.3 | 7.9 | -4.9 | 0.44 |
Na base fictícia, a maior variação foi em M04 (-9.9 pts, p = 0.12); variações com significância a 95%: nenhum mês. A carta de controle (linha central = NPS do período, limites de ±3σ ajustados ao n de cada mês) complementa o teste: ela mostra se o processo saiu do padrão, e não só se dois meses diferem.
Regra prática: antes de explicar uma variação, mostre a margem de erro dela. Comparar blocos de meses (trimestre contra trimestre) aumenta o n e revela mudanças de patamar que o mês a mês esconde.
3. O fator que mais explica o mês: tempo de resolução
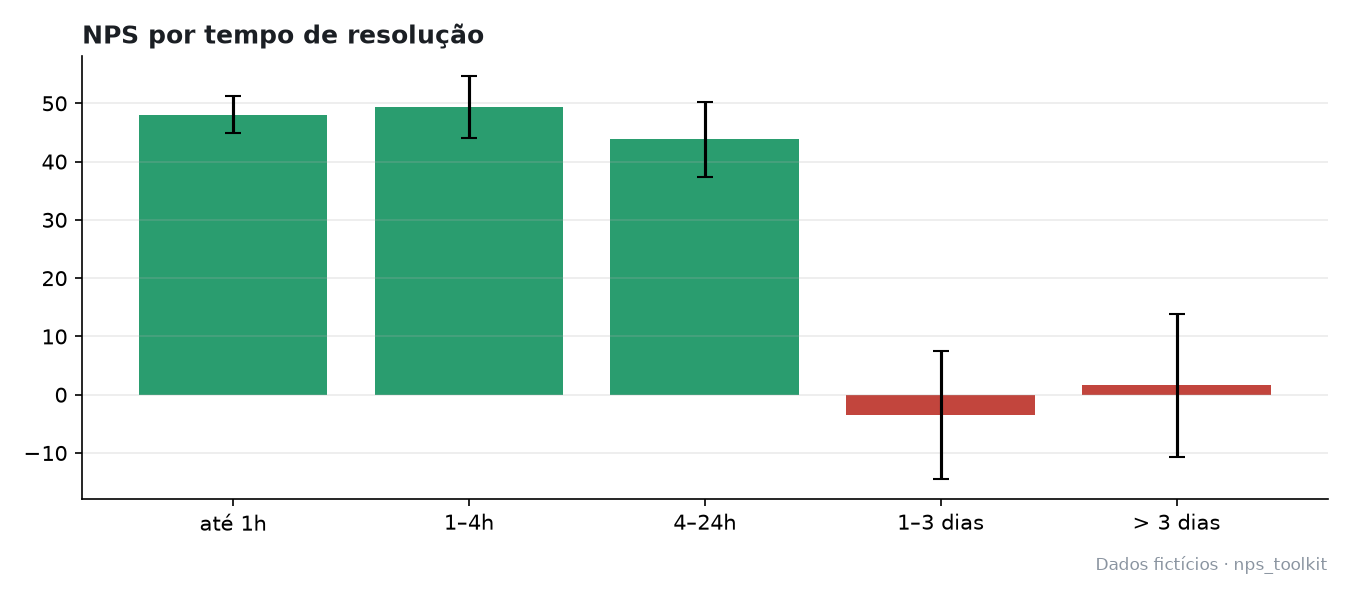
Casos resolvidos em até 24h têm NPS médio de 47; acima de 24h, -1. Quando a fatia de casos lentos oscila, o NPS do mês oscila junto, mesmo que o atendimento “bom” continue igual. Esse é o tipo de achado que tira a discussão do campo da opinião.
4. Mix × desempenho: a decomposição shift-share
Uma queda pode vir de duas fontes: (a) chegaram mais casos de um tipo que naturalmente avalia pior (mix) ou (b) o mesmo tipo de caso passou a ser avaliado pior (desempenho). A decomposição separa as duas de forma exata:
\(\Delta\mathrm{NPS} = \underbrace{\textstyle\sum_g (w_{g,1}-w_{g,0})\,\mathrm{NPS}_{g,0}}_{\text{mix}} + \underbrace{\textstyle\sum_g w_{g,1}\,(\mathrm{NPS}_{g,1}-\mathrm{NPS}_{g,0})}_{\text{desempenho}}\)
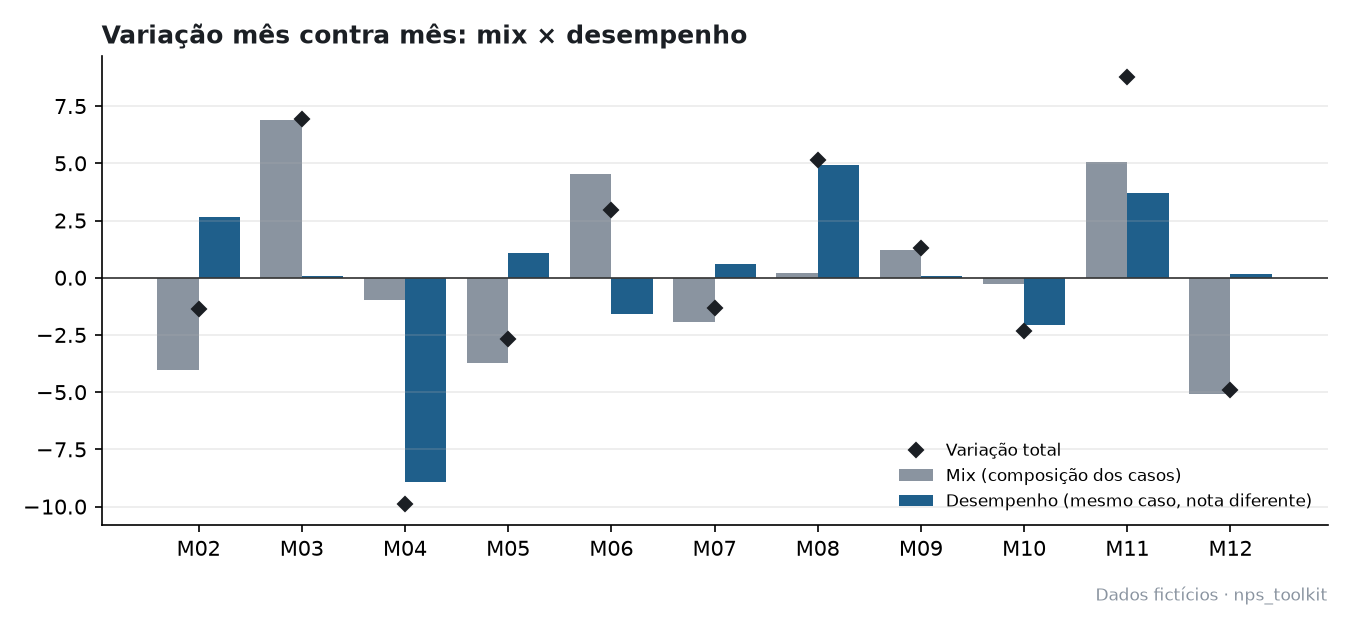
Mix pede ação de gestão de demanda e prazo (fila, priorização, WFM). Desempenho pede ação de tratativa (calibração, script, conhecimento). Confundir os dois é o erro mais caro da gestão de NPS.
5. Contrafactual: quanto um grupo de casos pesa no resultado
Pergunta simples e poderosa: qual seria o NPS sem um grupo específico de casos? Nos meses M05–M07 da base fictícia, um “evento sazonal” representou 17% das respostas, com NPS de 4, e respondeu por 29% dos detratores. Sem ele, o NPS do trimestre seria 44.0 em vez de 37.2. Isso mostra onde a causa está, muitas vezes fora da central: regra, comunicação ou prazo do produto.
6. Modelo no nível da resposta: o peso de cada fator
Uma regressão linear com \(y \in \{+100, 0, -100\}\) e fatores 0/1 tem uma leitura direta: cada coeficiente é quantos pontos de NPS aquele fator tira de uma resposta, mantidos os demais. O intercepto é o NPS esperado do caso-base. Uso erros-padrão robustos (HC1), porque y tem só três valores.
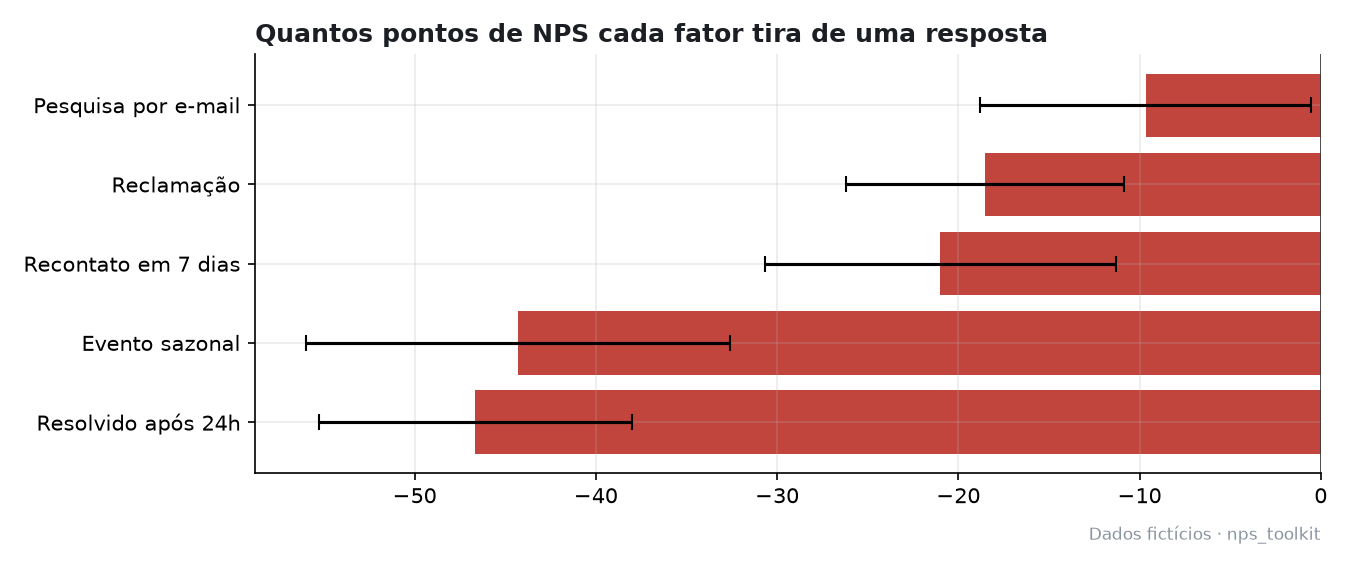
| Fator | Pontos de NPS | Erro-padrão | t |
|---|---|---|---|
| intercepto (caso-base) | +54.6 | 1.4 | 39.0 |
| Resolvido após 24h | -46.7 | 4.4 | -10.6 |
| Evento sazonal | -44.3 | 6.0 | -7.4 |
| Reclamação | -18.5 | 3.9 | -4.7 |
| Pesquisa por e-mail | -9.7 | 4.7 | -2.1 |
| Recontato em 7 dias | -21.0 | 4.9 | -4.2 |
Com o modelo, os cenários viram conta: reduzir pela metade os casos resolvidos após 24h levaria o NPS fictício de 42.2 para 44.8; zerar atraso levaria a 47.4. O caso-base (sem nenhum fator negativo) teria 54.6. Isso responde à pergunta da diretoria: “o que precisa acontecer para batermos a meta?”
7. Atendentes: dispersão sem ranking injusto
Ranquear atendentes pelo NPS bruto pune quem tem poucas respostas, cujo NPS é instável. Duas ferramentas resolvem: o gráfico de funil (limites de 95% que se estreitam com o n) e o encolhimento bayesiano empírico, que puxa cada NPS para a média geral na proporção da incerteza:
\(\mathrm{NPS}^{aj}_i = \bar{\mathrm{NPS}} + B_i\,(\mathrm{NPS}_i-\bar{\mathrm{NPS}}), \quad B_i = \dfrac{\tau^2}{\tau^2 + \mathrm{var}_i/n_i}\)
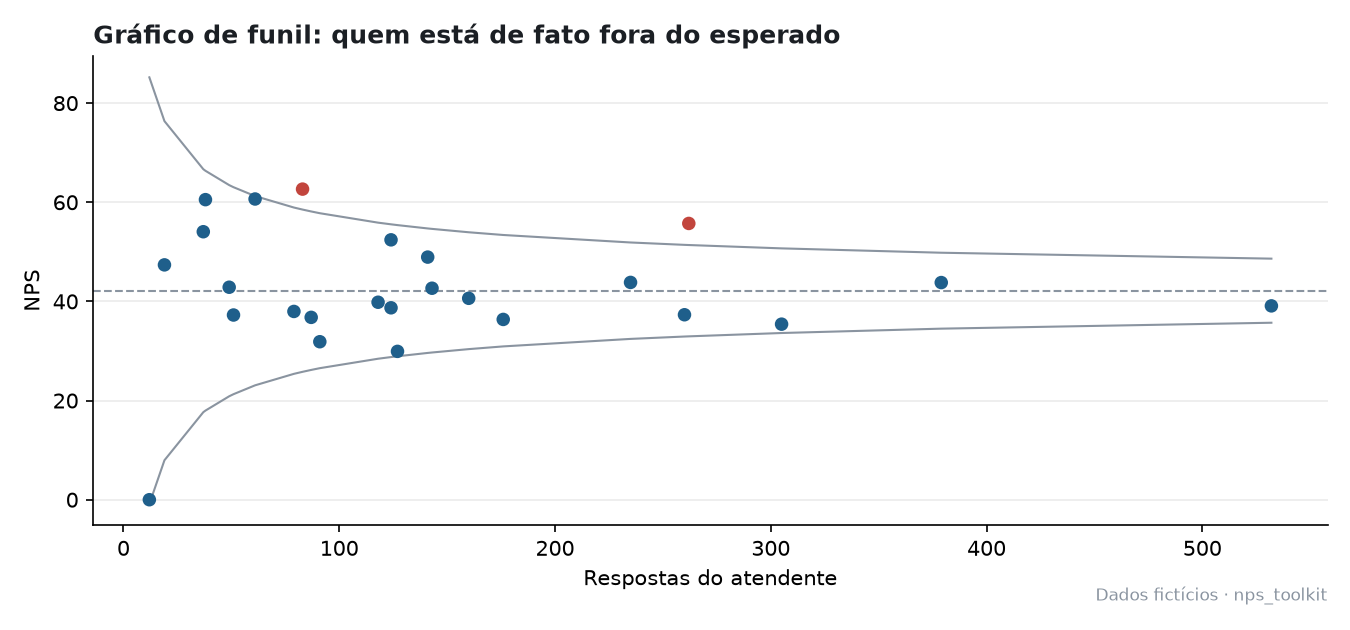
Entre os atendentes fictícios com 30+ respostas, o NPS bruto vai de 30 a 63; ajustado, de 37 a 52. A dispersão que sobra é real e é a prática boa a multiplicar, não um ranking para punir.
8. Voz do cliente: temas, monitoria e causa-raiz
Número diz quanto; comentário diz por quê. Uma classificação multitema por palavras-chave (com anonimização prévia de e-mail, CPF e telefone) já organiza a leitura. Sempre reporte o percentual sem tema: ele é o limite da classificação. Na base fictícia:
- Retorno e prazo: 48% dos comentários
- Resposta genérica: 17% dos comentários
- Sistema e acesso: 15% dos comentários
- Regra e elegibilidade: 12% dos comentários
- Sem tema identificado: 9% dos comentários
Na monitoria, a auditoria das notas detratoras por pilares de responsabilidade (por exemplo Conhecimento, Operacional, Sistema, Processo e Atitude, como no modelo do Projeto Promotor) separa o que é do atendente do que é do processo. Na prática, a maior parte da detração costuma estar em processo: retorno, prazo e regra.
9. Do diagnóstico à ação: a árvore de KPIs
NPS é resultado; quem o move são os indicadores de processo. Ligue cada achado a um KPI que a operação controla:
- Prazo → % de casos acima de 24h, SLA, TME, backlog por idade.
- Resolutividade → FCR e recontato em 7 dias.
- Tratativa → nota de monitoria por pilar, CSAT do atendimento, aderência a script.
- Esforço → CES e número de contatos por caso.
- Eficiência → TMA e produtividade, sempre lidos junto com qualidade.
E leve para o comitê semanal o NPS com margem de erro, o NPS dos grupos críticos e o cenário do modelo. Decisão boa nasce de pergunta boa.
10. Limites e boas práticas
- Mudança de canal da pesquisa (por exemplo, incluir e-mail) muda o perfil de quem responde: trate como quebra de série.
- Mês parcial não deve ser comparado com mês fechado.
- Mudança de tabulação de motivos cria tendências artificiais.
- Correlação entre poucos pontos mensais indica direção, não causa; prefira o nível da resposta.
- Comentários e dados de clientes devem ser anonimizados antes da análise.
Como usar o código
pip install numpy pandas matplotlib
python publicacao.py --saida _site   # gera esta página com a base fictícia

import pandas as pd, nps_toolkit as nt
df = pd.read_csv("sua_base.csv")          # colunas: mes, nota, fatores 0/1...
nt.teste_mes_a_mes(nt.nps_por(df, "mes"))
nt.decomposicao_mix(df, "mes", "faixa_resolucao", "M01", "M02")
nt.modelo_resposta(df, ["lento_24h", "reclamacao", "recontato_7d"])
Referências
- REICHHELD, F. F. The One Number You Need to Grow. Harvard Business Review, dez. 2003.
- KEININGHAM, T. L. et al. A Longitudinal Examination of Net Promoter and Firm Revenue Growth. Journal of Marketing, v. 71, n. 3, 2007.
- DIXON, M.; FREEMAN, K.; TOMAN, N. Stop Trying to Delight Your Customers. Harvard Business Review, jul.–ago. 2010.
- MONTGOMERY, D. C. Introduction to Statistical Quality Control. Wiley.
- SPIEGELHALTER, D. J. Funnel plots for comparing institutional performance. Statistics in Medicine, v. 24, n. 8, 2005.
- EFRON, B.; MORRIS, C. Data Analysis Using Stein's Estimator and its Generalizations. JASA, v. 70, n. 350, 1975.
- WHITE, H. A Heteroskedasticity-Consistent Covariance Matrix Estimator. Econometrica, v. 48, n. 4, 1980.
- MACIEL, A. L. Qualidade não é controle. É alavanca estratégica de resultado. Zenodo, 2026. doi:10.5281/zenodo.23891605.
- MACIEL, A. L. Não Só de Call Center Vive a Experiência do Cliente: qualidade estratégica, Voz do Cliente e análise de dados para transformar jornadas em resultados. Zenodo, 2026. doi:10.5281/zenodo.23898805.